-
CROSSAGENTIE: Cross-Type and Cross-Task Multi-Agent LLMCollaboration for Zero-Shot Information Extraction카테고리 없음 2026. 3. 21. 18:32
LLM은 비정형 텍스트를 생성하는 데 뛰어나다.
그러나 NER과 관계 추출(RE)과 같은 제로샷 정보 추출(IE)에서 정확성을 유지하면서 구조화된 출력을 생성하는 데 어려움을 겪는다.
이러한 문제를 해결하기 위해, 우리는 다중 에이전트 LLM 협업을 통해 제로샷 IE를 향상시키는 멀티에이전트 프레임워크인 CROSSAGENTIE를 제안한다.
CROSSAGENTIE는 두 가지 메커니즘을 통해 LLM의 예측을 반복적으로 정제한다.
하나는 문맥 기반 증거와 신뢰도 집계를 통해 개체-레이블 충돌을 해결하는 intra-group cross-type debate이고, 다른 하나는 NER과 RE가 양방향 피드백을 통해 서로의 출력을 상호 정제하는 inter-group cross-task debate이다.
더 나아가, 우리는 template fine-tuning을 도입하여, 높은 신뢰도의 멀티에이전트 출력 결과를 단일 모델에 증류함으로써 정확도를 유지하면서도 추론 비용을 크게 줄인다.
다섯 개의 NER 데이터셋과 다섯 개의 RE 데이터셋에 대한 실험 결과, CROSSAGENTIE는 제로샷 기준 최신 기법들보다 큰 폭으로 우수한 성능을 보였다.
CROSSAGENTIE는 제로샷 정보 추출을 위한 효과적이고 효율적인 접근법으로서, 구조화된 예측에서 LLM의 한계를 효과적으로 해결한다. 해당 GitHub는 https://github.com/Luca/CorssAgentIE 에서 확인할 수 있다.
정보 추출(IE)은 비정형 또는 반정형 텍스트로부터 구조화된 정보를 추출하는 것을 목표로 하는 자연어 처리(NLP)의 핵심 과제이다(Li et al., 2023; Lu et al., 2022). 여기에는 개체명 인식(NER)과 관계 추출(RE)과 같은 하위 과제가 포함된다. 전통적인 지도 학습 기반 IE 방법은 일반적으로 “사전학습 → 파인튜닝” 패러다임을 따른다. 이 방식에서는 사전학습된 언어 모델을 대규모 감독 신호가 포함된 라벨링 데이터셋에 적응시킨다(Devlin et al., 2019; Raffel et al., 2023; Zhuang et al., 2021). 이러한 방법은 효과적이지만, 높은 주석 비용과 제한된 일반화 성능이라는 한계를 가지며, 이로 인해 저자원 환경이나 빠르게 변화하는 도메인에서는 실용성이 떨어진다.
이러한 한계를 고려하여, 최근 연구는 유망한 방향으로서 제로샷 IE를 탐구해 왔다(Wei et al., 2024). 대규모 언어 모델(LLM)의 최근 발전(Lin et al., 2023; OpenAI, 2023b)은 전통적인 지도 학습 모델의 한계를 극복할 수 있는 보다 효과적인 제로샷 IE 방법을 가능하게 했다. 광범위한 사전학습을 통해 획득된 LLM의 강력한 언어 이해 능력은 이들이 IE 과제를 효과적으로 수행할 수 있도록 한다. LLM 기반 제로샷 IE 접근법에는 직접 프롬프팅(Han et al., 2024; Wang et al., 2023b; Xie et al., 2023a), 인컨텍스트 러닝(Brown et al., 2020; Min et al., 2022), 합성 데이터 생성(Heng et al., 2024), 그리고 파인튜닝을 위한 의사 라벨링(Gao et al., 2024a; Heng et al., 2024; Sainz et al., 2024; Zaratiana et al., 2024)이 포함된다. 이러한 방법들은 주석 데이터에 대한 의존도를 줄이고 적응성을 높여, LLM을 제로샷 IE를 위한 유망한 해법으로 만든다.
이러한 발전에도 불구하고, LLM은 여전히 제로샷 IE에서 성능을 제한하는 중대한 도전 과제들에 직면해 있다. 첫째, LLM은 IE에서 사전에 정의된 라벨링 스키마를 따르는 구조화된 출력을 생성하는 데 어려움을 겪는다. 구조화된 표현에 최적화된 전통적 모델과 달리, LLM은 주로 자유 형식의 텍스트를 생성한다. 기호(Wang et al., 2023b), 리스트(Zhou et al., 2024), 표(Jiao et al., 2023)를 사용하는 등의 프롬프팅 기법이 탐구되었지만, 구조화된 출력 생성에서의 불일치는 여전히 지속된다. 둘째, 동일한 개체가 일관되지 않은 범주를 부여받을 때 개체-레이블 충돌이 발생한다(예: “Washington”이 Location과 Person으로 모두 라벨링될 수 있음). 기존 접근법(Li et al., 2024a; Heng et al., 2024)은 이 문제를 약지도학습을 통해 해결하는데, 의사 라벨링된 데이터로 더 작은 모델을 파인튜닝하거나 제한된 주석으로부터 지식을 전이하는 방식을 사용한다. 그러나 이들은 LLM 표현에 내재된 고유한 추론 능력을 활용하기보다 외부 감독에 의존하므로, 보다 넓은 시나리오로의 일반화가 제한된다. 셋째, LLM은 도메인 적응에도 어려움을 겪으며, 과업 지시가 주어져도 도메인 특화 지식을 내재화하지 못한다. 프롬프트 엔지니어링을 통해 역할 특화 에이전트를 만들 수는 있지만(Lu et al., 2024; Wang and Huang, 2024), 이러한 방법은 광범위한 튜닝을 필요로 하고 도메인 간 일반화가 부족하다. 위의 세 가지 도전 과제로 인해, 현재의 LLM 기반 방법들은 제로샷 IE에서 높은 성능을 달성하는 데 어려움을 겪고 있다(Jiang et al., 2024b; Shen et al., 2023; Wan et al., 2023). 예를 들어, GPT-3.5에 대한 직접 프롬프팅은 NER에서 CoNLL03 기준 F1 45%(Li et al., 2024a), OntoNotes4 기준 34%(Xie et al., 2023a)에 불과하다.
이러한 문제를 해결하기 위해, 우리는 구조화된 토론과 양방향 정제를 통해 제로샷 NER 및 RE 성능을 향상시키는 멀티에이전트 LLM 협업 프레임워크인 CROSSAGENTIE를 제안한다. 첫째, intra-group cross-type debate는 문맥 기반 추론을 통해 분류를 검증함으로써 개체-레이블 충돌을 해결한다(예: "Washington"이 "Location"인지 "Person"인지 구별). 둘째, inter-group cross-task debate는 관계 기반 피드백을 통합함으로써 NER과 RE 예측을 정제하고, 양방향 지식 교환을 통해 문맥적 근거와 개체 정확성을 향상시킨다. 셋째, 도메인 적응을 강화하기 위해, CROSSAGENTIE는 type agent에 도메인 특화 메타데이터를 부여하여, 엔티티 타입 지식과 온톨로지 제약을 활용한 스키마 정렬 분류를 수행한다. 마지막으로, 추론 효율성을 높이기 위해, CROSSAGENTIE는 멀티에이전트 출력을 단일 모델로 증류하는 template fine-tuning을 도입한다. 이 과정은 계산 비용을 줄이는 동시에 도메인 간 일관성을 보장하여, CROSSAGENTIE의 효율성을 크게 향상시킨다. 다양한 데이터셋에 대한 실험 결과, CROSSAGENTIE는 최신 제로샷 기준선들을 큰 폭으로 능가하는 성능을 보인다.
IE를 위한 LLM
최근 LLM 기반 정보 추출(IE)의 발전은 NER과 RE와 같은 과제에서 가능성을 보여주고 있다. NER은 비정형 텍스트에서 개체를 식별하고 이를 사전에 정의된 범주로 분류하는 작업이며(Keraghel et al., 2024), RE는 텍스트로부터 개체 간의 관계를 추출하는 작업이다(Gao et al., 2024b). ChatIE(Wei et al., 2024)는 ChatGPT와의 구조화된 대화를 통해 IE를 향상시키며, 반복적 정제를 가능하게 한다. InstructUIE(Wang et al., 2023c)는 자연어 프롬프트를 사용하여 NER, RE, 사건 추출(EE)에서 LLM을 유도하기 위해 멀티태스크 지시 튜닝을 활용한다. ULTRA(Zhang et al., 2024a)는 계층적 프레임워크를 통해 EE를 향상시키며, 오픈소스 LLM을 활용하여 비용 효율적인 추출을 가능하게 하는 동시에 위치 편향을 완화한다.NER를 위한 LLM
여러 접근법은 LLM을 활용하여 NER을 향상시킨다. GPR-NER(Wang et al., 2023b)은 NER을 엔티티 마커와 자기 검증을 포함한 텍스트 생성 문제로 재구성하여, 퓨샷 및 인컨텍스트 러닝을 통해 과잉 예측을 줄인다. UniversalNER(Zhou et al., 2024)는 ChatGPT가 생성한 데이터를 instruction tuning을 통해 더 작은 LLaMA 기반 모델에 증류한다. VerifiNER(Kim et al., 2024)는 LLM과 외부 지식 베이스를 결합하여 사후 검증을 수행하고, 엔티티 경계와 타입을 정제한다. Decomposed-QA(Xie et al., 2023a)는 과제 분해, 구문적 증강, 그리고 ChatGPT를 이용한 self-consistency voting을 통해 NER을 개선한다. ProGen(Heng et al., 2024)은 단계별 생성과 자기 성찰을 사용하여 퓨샷 NER 데이터셋 구축과 엔티티 속성 정제를 향상시킨다.RE를 위한 LLM
여러 방법은 LLM을 활용하여 RE를 향상시킨다. GPR-RE(Wan et al., 2023)는 향상된 예시 검색과 추론을 통해 GPT의 인컨텍스트 러닝을 최적화한다. URE(Wang et al., 2023a)는 BERT(Devlin et al., 2019)와 함께 positive pair augmentation, margin loss, contrastive learning을 사용하여 관계 임베딩을 정제한다. QA4RE(Zhang et al., 2023)는 RE를 객관식 질의응답 과제로 재구성하며, 관계 템플릿을 instruction-tuned 선택지로 변환한다. G&O(Li et al., 2024a)는 제로샷 RE를 위해 “generation and organization” 파이프라인을 사용한다.IE를 위한 멀티에이전트 LLM
GPT(Brown et al., 2020; OpenAI, 2023b,a,c), LLaMA(Touvron et al., 2023), PaLM(Anil et al., 2023; Chowdhery et al., 2022)과 같은 LLM 기반 에이전트의 부상은 멀티에이전트 협업을 가능하게 했다. 이러한 시스템은 공유된 목표를 달성하기 위한 협력 전략(Zhang et al., 2024b; Zhou et al., 2023; Qian et al., 2024; Lu et al., 2024)을 따르거나, 출력을 정제하기 위한 적대적 전략(Aryan, 2024; Estornell and Liu, 2024)을 따른다. DAO(Wang and Huang, 2024)는 EE를 위한 멀티에이전트 최적화 프레임워크를 사용하여 LLM 출력을 정제하며, 외부 도구를 통합해 검색 품질과 예측 신뢰성을 향상시킨다. IE에 멀티에이전트 토론을 적용하는 것은 실시간 조정, 엔티티 충돌 해결(Liu et al., 2024), 효과적인 토론 관리(Cho et al., 2024)와 같은 과제를 수반한다. 이러한 과제를 해결하는 것은 특히 도메인 특화 맥락에서 IE 정확도를 향상시킨다.
이 절에서는 협업 에이전트를 사용한 구조화 정보 추출을 위한 다단계 프레임워크인 CROSSAGENTIE를 소개한다. 먼저 문제를 정식화하고(3.1절), 이어서 타입 에이전트 설정(3.2절), intra-group cross-type discussion(3.3절), inter-group cross-task discussion(3.4절), 마지막으로 template fine-tuning(3.5절)을 설명한다. 그림 1은 전체 프레임워크를 보여주며, 자세한 프롬프트는 부록 D에 제시되어 있다.
3.1 문제 정의
우리는 개체명 인식(NER)과 관계 추출(RE)을 구조화 정보 추출 과제로 정식화한다. n개의 단어로 이루어진 문장 $( s = {w_1, \ldots, w_n} )가 주어졌을 때, NER 과제는 ( s ) 내부의 텍스트 span을 개체 언급(entity mention)으로 식별하고, 각 언급에 사전에 정의된 온톨로지(예: Location, Person)로부터 하나의 라벨을 할당한다. 추출된 개체 집합은 ( E = {e_1, \ldots, e_k} )로 표시하며, 여기서 ( k )는 식별된 개체의 수이다. 각 개체 ( e_i )는 텍스트 span ( t_i )와 개체 라벨 ( l_i )로 구성되며, 즉 ( e_i = (t_i, l_i) )이다. ( E )를 바탕으로, RE 과제는 관계 집합 ( R = {r_1, \ldots, r_m} )을 추출하는데, 여기서 ( m )은 추출된 관계의 수이다. 각 관계 ( r_i = (e_p, r_i, e_q) )는 ( E ) 내 두 개체 ( e_p )와 ( e_q ) 사이의 방향성을 가진 관계 ( r_i )를 나타낸다. 추가로, 우리는 협업 에이전트 집합 ( A = {A_1, A_2, \ldots, A_M} )를 정의하며, 여기서 ( M )은 에이전트의 수를 의미하고, 이 에이전트들은 개체 인식 및 관계 추출 결과를 반복적으로 정제한다. 최종적으로 정제된 개체 및 관계 집합은 각각 ( E^* )와 ( R^* )로 표시되며, 반복 정제 과정을 통해 ( E^* = f(E, A) ) 및 ( R^* = g(R, A) )로 얻어진다. 여기서 ( f )와 ( g )는 에이전트 간 상호작용으로 모델링된 정제 함수이다.
3.2 타입 에이전트 설정
범주 간 혼동을 줄이고 분류 정확도를 높이기 위해, 우리는 각 개체 타입과 관계 타입을 하나의 특화된 에이전트에 할당한다. 여러 개체 및 관계 타입을 하나의 통합 프레임워크 안에서 처리하는 단일 멀티태스킹 모델을 사용하는 대신, 각 특화 에이전트가 맞춤형 프롬프팅 전략과 함께 과제 특화 의사결정을 수행한다. 예를 들어, NER 에이전트(PER, LOC 등)는 “Reagan”을 PER로, “America”를 LOC로 식별하며, RE 에이전트(Live-in 등)는 대표적 관계를 기반으로 head 및 tail entity를 추출한다. 타입 에이전트 프롬프팅에 대한 더 자세한 내용은 부록 D에 있다.
3.3 Intra-Group Cross-Type Discussion
타입 에이전트를 설정한 후, 동일한 개체에 대해 여러 에이전트가 서로 다른 라벨을 부여할 때 충돌을 해결하기 위한 구조화된 토론 메커니즘을 도입한다. 이 메커니즘은 충돌하는 에이전트들이 온톨로지 제약과 문맥적 추론을 통해 토론에 참여하고 자신의 분류를 정제할 수 있게 한다. 이 과정은 토론 기반의 반복 정제 프레임워크를 따르며, 에이전트들은 합의에 도달하기 위해 여러 차례의 토론 라운드에 참여한다. 각 타입 에이전트 ( A_i^{Type} )는 개체 집합 ( S_i^{Type} )를 생성하며, 동일한 개체에 대해 에이전트들이 일관되지 않은 라벨을 부여할 때 충돌이 발생한다. 충돌 집합은
( C = { e_i \mid \exists A_j^{Type}, A_k^{Type} \text{ such that } l_j(e_i) \neq l_k(e_i), \forall i \in T } )
로 정의된다.충돌 해결 과정에서, 에이전트 ( A_j^{Type} )와 ( A_k^{Type} )는 각 개체 ( e_i \in C )에 대해 이전 분류를 재평가하고, 해당 개체의 문맥을 다시 검토하며, 일관성을 보장하기 위해 온톨로지 기반 제약을 적용함으로써 자신의 분류를 반복적으로 정제한다. 합의에 도달하면, 해당 개체는 최종 타입을 할당받는다. 그렇지 않으면, 별도의 LLM인 Summarizer가 추론 경로, 신뢰도 점수, 문맥 증거를 집계하여 가장 가능성 높은 분류를 결정한다. 이러한 하이브리드 접근법은 구조화된 토론 기반 해결과 LLM 기반 통합을 결합함으로써 견고한 의사결정을 보장하고, 개체 타입 전반에 걸친 분류 정확도와 일관성을 향상시킨다.
3.4 Inter-Group Cross-Type Discussion
intra-group cross-type discussion을 통해 단일 과제 내의 충돌을 해결한 뒤, 우리는 inter-group cross-task discussion을 통해 출력을 추가로 정제한다. 이 과정에서 NER 에이전트와 RE 에이전트는 일관성을 높이기 위해 피드백을 교환한다. 이 단계에서 NER 에이전트는 추출된 개체 후보 집합을 생성하고, 이를 통해 RE 에이전트가 관계 추출에 적합한 관련 개체 타입에 집중하도록 유도한다. 예를 들어, “Live-in” 관계에서 RE 에이전트는 “Person”과 “Location”으로 구성된 개체 쌍(예: PER: Reagan; LOC: America)을 식별한다. 이후 추출된 개체를 바탕으로 RE 에이전트는 관계 진술(예: “Reagan lives in America”)을 생성하고, 이를 문맥 지식으로 NER 입력에 통합하여 개체 분류를 정제한다.
이러한 반복적 교환은 분류의 모호성을 해결하는 데 도움이 된다. 그림 1의 3단계에서, NER 에이전트는 처음에 “America”를 ORG와 LOC 모두로 잘못 분류한다. 그러나 “Live-in” 관계(즉, 사람은 조직이 아니라 장소에 거주해야 함)는 RE 에이전트가 “America”를 LOC로 확인하고 NER에 피드백을 제공하게 하며, 그 결과 잘못된 ORG 라벨이 제거된다. 유사하게, RE 에이전트는 처음에 “Reagan-America”를 “Live-in”과 “Work-for” 모두로 잘못 분류할 수 있다. 이때 NER 에이전트는 “America”가 LOC임을 검증함으로써 개체 일관성을 강화하고, RE가 관계 분류를 정제할 수 있도록 한다.
이 반복 정제 과정은 특정 분류 오류를 수정하지만, 더 넓은 차원의 과제가 남아 있다. 즉, NER과 RE가 일관되게 하나의 통합된 개체-관계 구조로 수렴하도록 어떻게 보장할 것인가 하는 문제이다. 제로샷 환경에서 NER과 RE는 독립적으로 동작하므로, 불일치가 자연스럽게 발생한다. NER은 RE와 관련 없는 개체를 추출할 수 있고, 반대로 RE에 필수적인 개체가 NER 출력에는 없을 수 있다. 이러한 불일치를 해결하기 위해, 우리는 NER과 RE가 추출한 개체와 요구하는 개체 사이의 대칭 차이를 명시적으로 정량화하는 수학적 정식을 도입한다. 이는
( \Delta(A, B) = (A \setminus B) \cup (B \setminus A) )
로 정의되며, 여기서 ( A = {NER_{ext}, RE_{ext}} )는 NER과 RE가 추출한 개체를 나타내고, ( B = {NER_{req}, RE_{req}} )는 NER과 RE가 요구하는 개체를 나타낸다. ( \Delta(A, B) )를 최소화함으로써, 우리는 개체 경계와 관계 예측 사이의 정렬을 개선하고, 불필요한 개체와 누락된 개체를 모두 줄인다. 개체 불일치의 정의, 논리 제약의 역할, 예측 불일치 최소화를 포함한 전체 수학적 세부 사항은 부록 F에 제시되어 있다.3.5 Template Fine-tuning
intra-group discussion을 통해 충돌을 해결하고, NER과 RE 사이의 inter-group 상호작용을 통해 예측을 정제한 이후, 우리는 추론 효율성을 추가로 최적화한다. 구조화된 협업은 분류 정확도를 향상시키지만, 그 반복적 특성 때문에 상당한 계산 비용이 발생하며, 특히 멀티라벨 데이터셋에서 더욱 그렇다. 이를 완화하기 위해, 우리는 높은 신뢰도의 출력을 단일 모델로 증류하는 template fine-tuning을 제안한다. 여러 에이전트로부터 정제된 결과를 통합함으로써, 이 접근법은 정확도를 유지하면서 멀티라벨 데이터셋에서 제로샷 성능을 향상시키고, 계산 오버헤드를 크게 줄인다. 자세한 내용은 부록 J를 참조하라.
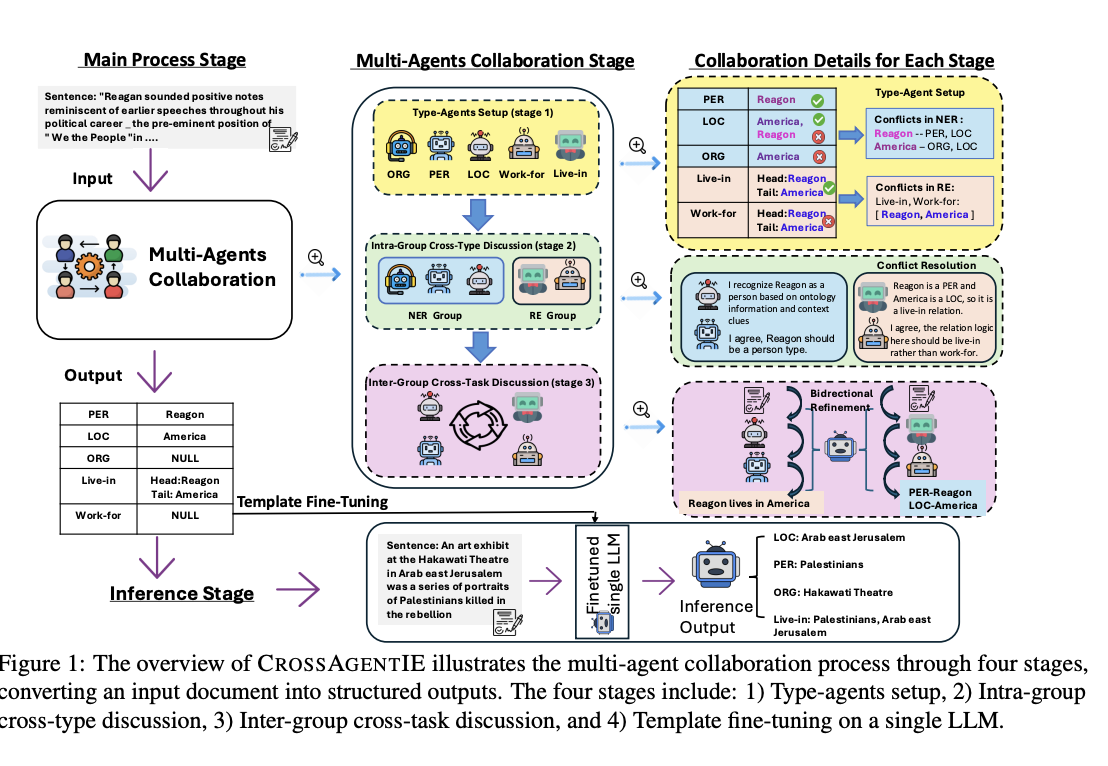
우리는 strict full-matching 기준을 사용하여 NER 및 RE 벤치마크에서 CROSSAGENTIE를 평가하고, 이를 최신 기준선들과 비교한다. 기존 연구(2절)에서 LLM이 다양한 설정에 적용되었기 때문에, 우리는 가장 관련성 높은 최신(state-of-the-art, SOTA) 제로샷 접근법을 선택한다. 방법 비교는 부록 B를 참조하라. 공정한 비교를 위해, 기존 기준선들과 일치하도록 GPT-3.5를 백본으로 사용하고, 추가적으로 더 진보된 LLM에서의 평가를 위해 GPT-4o에서도 우리의 접근법을 테스트한다. 자세한 내용은 4.3절을 참조하라.
4.1 실험 설정
NER 데이터셋
우리는 CONLL03 (Tjong Kim Sang and De Meulder, 2003), CONLL04 (Carreras and Màrquez, 2004), OntoNotes4 (Pradhan et al., 2013), Semeval (Hendrickx et al., 2010), TACRED (Zhang et al., 2017)에서 NER 성능을 평가한다. 자세한 내용은 부록 A.2를 참조하라.NER 기준선
우리는 CROSSAGENTIE를 다음 기준선들과 비교한다.
(1) Self-consistency (Wang et al., 2023d): 안정성을 개선하기 위해 다수의 출력을 투표를 통해 집계하는 방법.
(2) Soft Self-consistency (Wang et al., 2024): 불확실성을 고려한 집계를 사용하여 투표 결정을 완화하는 방법.
(3) All-Entity-in-One (AEiO) (Li et al., 2024a): 단일 모델에서 여러 엔터티 타입을 추출하며, 모든 범주를 함께 처리하는 방법(예: “문장에서 person, location, organization 엔터티를 식별하라”).
(4) Type-Agents: 각기 특정 타입에 집중하는 여러 개의 특화된 LLM 프롬프트를 사용하는 방법.
(5) Template fine-tuning: 증류된 출력을 사용하여 단일 LLM을 파인튜닝하는 방법.RE 데이터셋
우리는 CONLL2004, Semeval, TACRED, NYT (Face, 2025), SciERC (Luan et al., 2018)에서 RE 성능을 평가한다. 자세한 내용은 부록 A.2를 참조하라.RE 기준선
우리는 CROSSAGENTIE를 다음 기준선들과 비교한다.
(1) One-step (Li et al., 2024a): 구조화된 형식의 단일 프롬프트 안에서 엔터티와 그 관계를 공동으로 추출하는 방법.
(2) Direct-prompting: 단일 단계에서 관계 triplet을 추출하는 방법.
(3) Type-Agents 및
(4) Template fine-tuning: NER과 동일한 설정을 따른다.구현 세부사항
우리는 GPT-3.5-Turbo (OpenAI)를 사용하여 제로샷 실험을 수행한다. 각 엔터티 타입에는 전용 타입 에이전트가 할당되며, 엔터티 라벨 집합과 일대일 대응이 되도록 한다. 우리의 프레임워크는 Microsoft의 오픈소스 Autogen¹ 위에 구축되었다. 온도는 0.9, 최대 반복 횟수는 2, frequency penalty는 0.1로 설정하였다.지표 및 평가
우리는 strict span-level matching을 사용하여 micro-averaged precision, recall, F1-score²를 계산한다. 여기서 ground truth 엔터티와 정확히 일치하는 경우에만 true positive로 계산된다. 자세한 내용은 부록 A.3을 참조하라.4.2 주요 결과
우리는 NER 및 RE 테스트셋 전반에서 micro F1-score를 사용하여 모든 방법의 성능을 평가한다.
NER에서의 주요 결과
주요 NER 결과로서, 표 1은 다양한 프롬프팅 전략을 사용했을 때 GPT-3.5가 달성한 F1-score를 제시한다. CROSSAGENTIE의 효과는 분명하며, 이는 모든 데이터셋에서 AEiO 접근법과 Type-Agents를 일관되게 능가하고, 평균적으로 AEiO 대비 8.56%, Type-Agents 대비 7.63%의 F1-score 향상을 달성한다. 우리는 또한 기존의 Self-consistency (SC) 및 Soft Self-consistency 프레임워크와 CROSSAGENTIE를 비교하여 그 효과를 검증한다. 표 4에서 볼 수 있듯이, CROSSAGENTIE는 SC 및 Soft SC보다 각각 5.97%, 11.32% 더 높은 F1-score를 보인다.RE에서의 주요 결과
주요 RE 결과로서, 표 5는 다양한 방법에 대해 GPT-3.5가 달성한 F1-score를 제시한다. Direct-Prompting 및 Type-Agents와 비교했을 때, CROSSAGENTIE는 모든 데이터셋 전반에서 Direct-Prompting 대비 평균 9.13%, Type-Agents 대비 평균 5.54%의 F1 향상을 달성하며, 관계 추출에서의 견고성을 보여준다.Template Fine-tuning 결과
표 1과 5는 template fine-tuning이 zero-shot inference보다 성능을 향상시킨다는 것을 보여준다. CONLL04 NER 데이터셋에서, AEiO 방법은 58.13%의 F1-score를 달성한 반면, template fine-tuning은 이를 68.38%로 끌어올려 10.25% 향상시켰다. 모든 데이터셋 전반에서, template fine-tuned GPT-3.5는 모든 기준선을 능가하며, NER 성능은 AEiO 대비 평균 7.25%, RE 성능은 Direct-Prompting 대비 평균 6.08% 향상되었다.토론에서의 공정성과 편향 제어
공정성을 보장하기 위해, 모든 타입 에이전트는 동일한 가중치를 가지며, 이를 통해 특정 에이전트 하나가 분류를 지배하지 못하도록 한다. 발화 순서는 위치 편향을 제거하기 위해 무작위로 정해진다. 합의에 도달하지 못하면, Summarizer LLM이 근거와 신뢰도 점수를 집계하여 최종 결정을 내리며, 이는 3.3절에 자세히 설명되어 있다. 이러한 메커니즘은 편향되지 않고 균형 잡힌 토론을 보장한다.추가 결과
우리는 다양한 백본 모델에 걸쳐 Type-Agents 기준선 내에서 self-verification reasoning (Weng et al., 2023)을 평가한다. 그림 3에서 볼 수 있듯이, self-verification은 그 복잡성에도 불구하고 데이터셋과 모델 크기 전반에 걸쳐 zero-shot 설정에서 성능을 저하시킨다. 추가 분석은 부록 C를 참조하라.Method CONLL04
Self-consistency (SC)
(Wang et al., 2023d) 60.48
Soft SC (Wang et al., 2024) 55.13
CROSSAGENTIE
-Type-Agents 55.73- CROSSAGENTIE 66.45†
-Template-finetuning (One-LLM) 68.38
표 4: 다양한 전략을 사용한 NER 과제—CONLL04에서 GPT-3.5의 F1 점수(%).
4.3 절제 연구
우리 접근법의 핵심 구성 요소들의 기여도를 평가하기 위해, 우리는 다섯 가지 측면에 초점을 맞춘 절제 연구를 수행한다. (1) 다른 zero-shot 방법과의 비교, (2) 백본 모델 선택, (3) 모델 구조 설계, (4) conflict debate의 효과성, (5) template fine-tuning 최적화. 이러한 연구는 각 구성 요소가 NER과 RE 모두에 미치는 영향을 정량화한다.
NER 기준선 비교
우리는 NER에 대한 기존 zero-shot LLM 방법들과 우리의 접근법을 비교한다. 여기에는 IE 과제에서 GPT-3.5의 zero-shot 성능을 분석한 단순하지만 효과적인 연구인 G&O (Li et al., 2024a), self-annotation, pseudo-demonstrations, consistency-based filtering을 통해 zero-shot NER을 향상시키는 Self-Improving for Zero-Shot NER with LLM (Xie et al., 2024), 그리고 ChatGPT를 사용한 zero-shot NER을 탐구한 Decomposed-QA (Xie et al., 2023b)가 포함된다. 표 2와 6에서 볼 수 있듯이, CROSSAGENTIE는 CoNLL03에서 G&O보다 7.07%, Self-Improving보다 0.56% 더 높은 F1-score를 보이며, OntoNotes에서는 Decomposed-QA보다 5.98% 더 높은 F1-score를 달성한다. 또한 단일 LLM을 사용하는 zero-shot 설정에서, 우리의 template fine-tuned 모델은 G&O보다 5.91%, Decomposed.보다 2.36% 더 높아 그 효과를 더욱 입증한다.RE 기준선 비교
우리는 RE 과제에서 One-step 및 G&O (Li et al., 2024a)를 포함한 기존 zero-shot LLM 방법들과 우리의 접근법을 비교한다. 표 3에서 볼 수 있듯이, CROSSAGENTIE는 CoNLL04 데이터셋에서 One-step보다 5.63%, G&O보다 10.83% 더 높은 F1-score를 보인다. 단일 LLM을 사용하는 zero-shot 설정에서, 우리의 template fine-tuned 모델은 One-step보다 2.48%, G&O보다 7.68% 더 높다.백본 모델 선택
우리의 실험은 GPT-3.5³, LlaMa3-8b⁴, Mistral-7B (Jiang et al., 2023), Mixtral 8x7B (Jiang et al., 2024a)를 백본 LLM으로 사용한다. 그림 3은 세 가지 평가 설정(Type-Agents, Self-Verification, Our method)에서 이들의 NER 성능을 제시한다. 어떤 추론 방법을 사용하든, GPT-3.5는 precision, recall, F1-score에서 다른 모델들을 일관되게 능가하며, 더 강력한 백본 모델이 전체 성능에 미치는 중요한 영향을 보여준다. 이는 GPT-3.5가 우리의 debate-driven multi-agent framework에 최적의 선택임을 뒷받침한다. 추가로, 우리는 GPT-4o⁵를 사용하여 우리의 접근법을 평가하며, CoNLL04 데이터셋에서의 결과는 표 7에 제시된다. Type-Agents NER 기준선의 자세한 비교와 추가 세부사항은 부록 A.1을 참조하라.³
https://platform.openai.com/docs/models#
gpt-3.5⁴
https://ai.meta.com/blog/meta-llama-3/프레임워크 설계 비교
강력한 백본 모델이 필수적이기는 하지만, 추론 프레임워크도 마찬가지로 중요하다. single-step summarization 접근법은 반복적 추론 대신 1차 라운드 응답을 먼저 요약함으로써 계산 비용을 줄인다. 그러나 이는 정제와 더 깊은 추론을 희생시키는데, 이것들은 우리의 debate-driven framework의 핵심 강점이다. 이 trade-off를 평가하기 위해 우리는 두 방법을 비교했으며, 부록 I의 결과는 우리의 구조화된 토론이 성능과 효율성 면에서 더 우수함을 확인해 준다.충돌 해결 효율성
엔터티 분류 충돌은 우리의 멀티에이전트 토론 시스템에서 핵심 과제이다. 우리는 300개의 CoNLL03 문서를 분석하여 688개의 conflict instance를 확인했으며, 이 중 77.5%가 단일 토론 턴 안에서 성공적으로 해결되었다. 해결되지 않은 사례 중 35개는 false positive였고, 단 6개만이 추가 라운드를 필요로 했으며, 이는 복잡한 사례를 처리하는 시스템의 효율성을 보여준다.구조화된 토론의 효과성
우리는 CoNLL04에서 절제 연구를 수행하여 NER 및 RE에 대한 structured debate의 영향을 평가한다. 비교한 네 가지 설정은 다음과 같다. (1) debate가 없는 Type-Agents, (2) RE에 대해서만 debate 수행, (3) NER에 대해서만 debate 수행, (4) 둘 다에 대해 debate 수행. 표 13은 structured debate가 엔터티 분류를 정제하고 라벨 모호성을 해결함으로써 성능을 향상시킨다는 것을 보여주며, 자세한 내용은 부록 G에 있다. 반복적인 NER-RE 상호작용의 이점을 추가로 평가하기 위해, 우리는 cross-task refinement가 예측을 향상시키는 2차 라운드 피드백 실험을 수행한다. 표 12에서 볼 수 있듯이, 이러한 반복 피드백은 누락된 엔터티를 복구하고 관계 분류를 정제함으로써 recall을 향상시킨다. 자세한 내용은 부록 H를 참조하라.Template Fine-tuning 최적화
우리의 template fine-tuning 메커니즘은 multi-agent refinement의 성능에 맞추는 것을 목표로 한다. 최대 정확도를 위해 단일 LLM을 최적화하고자, 우리는 최상의 F1-score를 달성하는 데 필요한 최적의 사례 수를 탐색한다. CONLL04 데이터셋에서 NER 및 RE 과제의 case count를 변화시키며 실험한 결과(그림 2), NER에서는 타입당 5개의 사례, RE에서는 타입당 3~4개의 사례가 최적임을 확인했다. 자세한 내용은 부록 J를 참조하라.비용 및 시간 효율성
우리는 긴 토론과 짧은 토론에 대해 데이터 포인트당 비용과 시간 소비를 평가한다. Efficiency Score를 비용 효율성의 척도로 사용했을 때, 우리의 프레임워크는 계산 효율성과 성능 사이에서 최적의 균형을 이룬다. 최종 결과는 데이터셋별로 필요한 토론 라운드 수에 따라 달라지며, 이는 확장 가능한 응용에서의 실용성을 보여준다. 자세한 내용은 부록 L을 참조하라.Error Types Baseline-NER 1st-Debate-NER 2nd-Feedback-NER
Boundary Errors 90 81 90
Wrong types 333 251 343
Missing Entities 686 680 618
Total 1109 1012 1051표 8: CONLL04의 NER에 대한 오류 유형 개수: Baseline, 1차 Cross-Type Discussion, 2차 Cross-Task Discussion의 비교. 굵은 숫자는 총 오류 수를 나타내며, 우리 방법이 달성한 감소를 보여준다.
4.4 사례 연구
오류 분석
우리는 CONLL04 데이터셋에서 우리의 멀티에이전트 프레임워크의 오류를 분석하고, 모델의 한계를 파악하고 개선 방향을 제시하기 위해 이를 세 가지 유형으로 분류한다.오류 유형 및 통계
표 8은 오류 통계를 요약하며, 오류를 wrong type errors, boundary errors, missing entities의 세 범주로 분류한다.- Wrong type errors는 엔터티가 사전에 정의된 라벨 집합에서 잘못된 타입으로 할당되는 경우 발생한다.
- Boundary errors는 예측된 span이 gold annotation과 정렬되지 않을 때 발생하며, 완전히 포함하거나, 포함되거나, 혹은 부분적으로 겹치는 경우를 포함한다.
- Missing entities는 gold 엔터티가 탐지되지 않은 경우를 의미한다.
추가적으로, 모델이 존재하지 않는 엔터티를 예측하는 spurious entity errors도 고려하지만, 우리의 주요 초점은 세 가지 핵심 오류 유형에 있다. 오류 분포의 세부 내역, 모델 단계별 영향, 사례 연구는 부록 K를 참조하라.
오류 수정 및 오류 증가의 사례 연구
표 8에서 볼 수 있듯이, Cross-task Debating은 Boundary Errors와 Wrong Types errors를 효과적으로 줄인다. Baseline 단계에서는 오류가 false negatives (FN)와 false positives (FP)에 의해 지배되어 최적이 아닌 성능으로 이어진다. 1st-Debate-NER 단계는 FP를 크게 줄이고 FN도 약간 감소시켜 precision과 F1-score를 향상시킨다. 2nd-Feedback-NER 단계는 FN을 추가로 줄여, FP가 소폭 증가함에도 불구하고 recall을 8.73% 향상시킨다. 이는 FN이 주요 오류 원인일 때, 2nd-Feedback-NER에서의 RE 기반 지식 증강이 FN을 효과적으로 줄여 recall과 F1-score를 높인다는 것을 보여준다. FP가 약간 증가하더라도, FN 감소가 순 성능 향상으로 이어진다. 자세한 내용은 부록 K를 참조하라.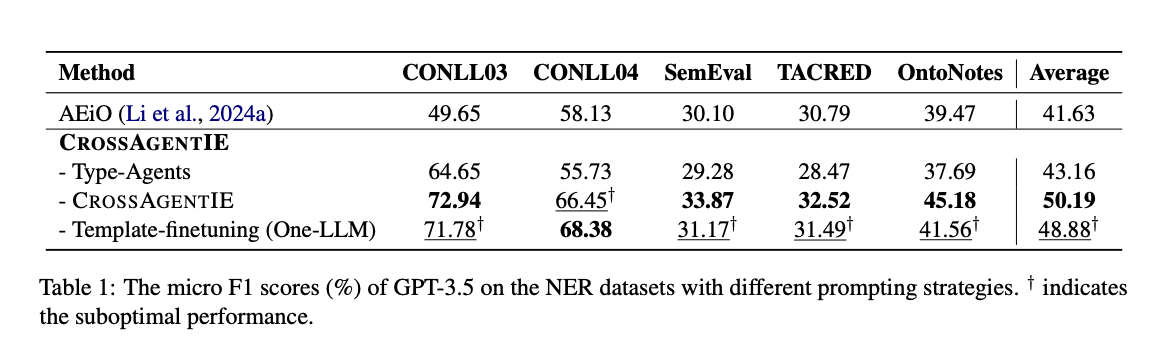
본 논문에서는 LLM을 활용한 정보 추출(IE) 과제에서 구조화된 예측을 향상시키기 위해 설계된, cross-type 및 cross-task 멀티에이전트 협업 프레임워크인 CROSSAGENTIE를 제안하였다. 기존의 제로샷 전략과 달리, CROSSAGENTIE는 NER과 RE 과제 간 상호 정제를 가능하게 하는 두 가지 협업 메커니즘을 도입하여 예측 정확도를 향상시킨다. 또한 우리는 출력 지식을 단일 모델에 통합하기 위한 template fine-tuning을 개발하여 효율성을 크게 높였다. GPT-3.5를 사용한 제로샷 IE 설정에서의 실험 결과, 우리의 양방향 협업과 template fine-tuning은 상당한 성능 향상을 달성하였으며, 이를 통해 CROSSAGENTIE의 효과성을 입증하였다. 절제 연구는 멀티에이전트 시스템의 각 구성 요소의 효율성을 추가로 검증하였고, 다양한 LLM과 데이터셋에 걸친 평가는 CROSSAGENTIE의 일반화 가능성을 보여주었다. 우리는 본 연구가 LLM의 멀티에이전트 협업 프레임워크에 대한 향후 연구에 영감을 주고, 효과적이고 해석 가능한 IE 시스템 개발에 기여하기를 기대한다.
감사의 말
본 연구는 NSF NAIRR Pilot with PSC Neocortex and NCSA Delta, Commonwealth Cyber Initiative, Children’s National Hospital, Fralin Biomedical Research Institute (Virginia Tech), Sanghani Center for AI and Data Analytics (Virginia Tech), Virginia Tech Innovation Campus, 그리고 Cisco Research 및 Amazon + Virginia Tech Center for Efficient and Robust Machine Learning의 아낌없는 지원을 받아 수행되었다.
한계
계산 자원의 제약으로 인해, 우리의 평가는 제한된 수의 데이터셋과 과제에서 수행되었다. 이러한 실험들은 CROSSAGENTIE의 효과성을 보여주지만, 더 많은 도메인 특화 데이터셋을 포함하면 우리의 결론의 견고성을 더욱 높일 수 있을 것이다. 아래에서는 우리 접근법의 주요 한계를 설명한다.
계산 비용
우리의 멀티에이전트 프레임워크는 반복적 토론과 양방향 정제로 인해 추가적인 계산 오버헤드를 수반한다. template fine-tuning이 추론 비용을 줄여주기는 하지만, 초기 토론 과정은 여전히 비용이 많이 들며, 특히 대규모 데이터셋에서 더욱 그렇다.멀티에이전트 협업에서의 확장성
에이전트 수가 증가할수록 조정의 복잡성도 커진다. 대규모 설정에서 충돌을 관리하고 수렴을 보장하려면 과도한 추론 시간을 방지하기 위한 추가적인 최적화가 필요하다.모델 정확도에 대한 의존성
이 프레임워크는 LLM의 추론 능력에 의존하는데, 이 과정에서 여전히 환각된 출력이나 일관되지 않은 출력이 생성될 수 있다. intra-group 및 inter-group 토론이 오류를 완화하는 데 도움을 주지만, 엔터티 인식과 관계 추출에서 잘못된 분류가 여전히 발생할 수 있다. 또한 대규모 언어 모델 생성의 본질적 불안정성으로 인해 편향, 신뢰 문제, 기타 불확실성이 나타날 수 있으며, 이는 추출된 정보의 신뢰성을 약화시킬 수 있다.온톨로지 제약
우리의 접근법은 사전에 정의된 엔터티 및 관계 온톨로지 내에서 동작하므로, 오픈 도메인이나 계속 변화하는 스키마에 대한 적응성이 제한된다. 이를 동적인 온톨로지로 확장하려면 확장과 적응을 위한 추가적인 메커니즘이 필요하다. - CROSSAGENTIE 66.45†