-
[논문 리뷰] 52. An Empirical Study of Group Conformity in Multi-Agent Systems논문 2026. 1. 11. 22:44
LLM의 발전은 인간 수준의 추론을 통해 현실 세계의 상호작용을 모사하는 멀티에이전트 시스템을 가능하게 하였습니다.
기존 연구들은 인종과 같은 보호 대상 속성과 관련된 편향을 광범위하게 검토해 왔으나, 사회적으로 논쟁적인 이슈에서 멀티에이전트 LLM 상호작용을 통해 발생하고 전파되는 편향에 대해서는 아직 충분히 탐구되지 않았습니다.
본 연구는 다섯 가지 논쟁적 주제에 대한 토론을 통해 LLM 에이전트가 공적 여론을 어떻게 형성하는지를 탐구합니다.
2,500회 이상의 토론을 시뮬레이션함으로써, 초기에는 중도적 성향을 부여받은 중립적 에이전트들이 시간이 지남에 따라 특정 입장을 채택하는 과정을 분석합니다.
통계적 분석 결과, 인간 행동을 모방한 유의미한 집단 동조 현상이 관찰되었으며, LLM 에이전트들은 수적으로 우세한 집단이나 더 높은 지능을 가진 에이전트의 입장에 정렬되는 경향을 보였고, 이러한 에이전트들이 더 큰 영향력을 행사하는 것으로 나타났습니다.
이러한 결과는 담론 형성에서 에이전트 지능이 차지하는 핵심적 역할을 강조하며, 온라인 상호작용에서 편향이 증폭될 위험성을 부각합니다.
본 연구의 결과는 익명성이 보장된 온라인 환경에서 편향 전파의 위험을 완화하기 위해 LLM이 생성하는 토론에서 다양성과 투명성을 촉진하는 정책적 조치의 필요성을 강조합니다.
연구자들은 여러 LLM을 활용하여 멀티에이전트 시스템을 구축하고 있으며, 이를 통해 발산적 사고, 메타 평가, 그리고 기타 협업 과제와 같은 복잡한 에이전트 간 상호작용을 가능하게 하고 있습니다.
LLM 에이전트는 인간의 지적 활동과 의사결정을 강화하기 위해 다양한 응용 분야에 통합되고 있습니다.
이러한 발전은 인간 상호작용을 보다 정교하게 시뮬레이션할 수 있게 하는 한편, 복잡한 도전 과제 또한 야기합니다.
그중 하나의 주요 우려는 편향된 출력이 발생할 위험입니다.
기존 연구들은 주로 LLM이 생성한 콘텐츠에서 성별이나 인종과 같은 명시적 편향을 측정하고 완화하는 데 초점을 맞추어 왔습니다.
그러나 LLM이 멀티에이전트 시스템으로 전환됨에 따라, 에이전트 간 상호작용이 어떻게 편향을 생성하고, 전파하며, 강화하는지를 검토하는 것이 필수적입니다.
집단 동조나 침묵의 나선과 같은 현상에 대한 오랜 사회과학 연구를 바탕으로, 이제 이러한 통찰을 미묘하고 인간과 유사한 상호작용을 수행하는 LLM 에이전트 시스템에 적용할 수 있습니다.
본 연구에서는 다섯 가지 사회적으로 논쟁적인 주제(예: “보편적 기본소득(UBI)은 현대 사회에 필요한가?”)에 초점을 맞춥니다.
이러한 주제들은 본질적으로 논쟁적이며 명확한 정답이 없지만, 최근 연구에서 지적된 바와 같이 중요한 사회적 함의를 지니고 있습니다.
익명적으로 의견이 교환되는 온라인 환경에서 LLM 에이전트의 영향력이 커지고 있는 상황에서, 공적 담론을 형성하는 과정에서 이들의 역학을 이해하는 것은 특히 중요합니다.
이에 따라 본 연구는 이러한 주제에 대한 견해를 공유하는 과정에서 LLM 에이전트가 어떻게 공적 여론을 형성하고 집단 동조를 유도하는지를 관찰하는 것을 목표로 합니다.
선행 연구는 LLM 에이전트가 서로 다른 정체성을 부여받았음에도 불구하고, 기반 모델이 지닌 고유한 편향에 동조한다는 점을 보여주었습니다.
해당 연구가 찬성 및 반대 에이전트가 중립 에이전트의 편향으로 수렴하는 방식을 다루었다면, 본 연구는 초점을 중립 에이전트 자체로 이동시켜, 어떠한 요인이 중립 에이전트의 암묵적 편향에 영향을 미치고 동조를 유도하는지를 분석합니다.
우리는 집단 규모와 지능의 영향을 조사하며, 중립 에이전트가 입장을 형성할 때 논거의 양과 질을 모두 고려할 것이라는 가설을 설정합니다. 의견 형성에서의 사회적 역학을 분석함으로써, LLM 주도 담론이 미치는 보다 광범위한 영향을 이해하고자 합니다.
우리는 초기에는 중도적 성향을 부여받은 중립 에이전트가 다수 의견에 정렬하는 조건을 분석함으로써, LLM 에이전트 간 집단 동조를 실증적으로 검토합니다.
찬성, 반대, 중립 에이전트로 구성된 멀티에이전트 시스템을 사용하여 토론을 시뮬레이션합니다.
찬성 및 반대 에이전트가 각각의 의견을 제시하는 동안, 중립 에이전트는 각 턴이 끝날 때 양측을 평가하고 자신의 입장과 가장 잘 부합하는 견해를 채택합니다.
2,500회가 넘는 토론 시뮬레이션 전반에 걸쳐, 중립 에이전트가 다수 의견이나 더 설득력 있는 입장에 정렬하는 빈도와 정도를 모두 측정하여 동조를 정량화합니다.
통계 분석을 통해 검증된 실험 결과는 멀티에이전트 시스템에서 다수 효과가 존재함을 보여줍니다.
특히, 대규모 LLM로 구동되는 단일 고지능 에이전트가 소규모 LLM로 구동되는 다수의 저지능 에이전트 집단보다 중립 에이전트에 더 효과적으로 영향을 미칠 수 있음을 확인하였습니다.
이러한 결과는 에이전트 기반 시스템에서 담론의 역학이 지능 격차에 의해 강하게 좌우되며, 공적 여론 형성과 편향 강화에 중요한 시사점을 지님을 나타냅니다.
본 연구는 멀티에이전트 시스템에서의 의견 역학에 대한 이해에 기여하며, 동조 현상에 대한 실증적 증거를 제공합니다.
이는 인간 사회 역학에서 광범위하게 연구된 다수 영향과 소수 억압과 같은 현상이 LLM 상호작용에서도 나타난다는 점을 보여줍니다. 저희가 아는 한, 본 연구는 LLM 에이전트가 다수 의견뿐만 아니라 더 높은 지능을 가진 모델에도 정렬함으로써, 보다 극단적인 결과로 이어질 수 있음을 처음으로 입증한 연구입니다. 이러한 발견은 LLM이 생성하는 담론에서 편향이 전파될 위험성을 강조하며, 공적 여론 형성 과정에서 다양성과 투명성을 촉진하기 위한 정책적 개입의 필요성을 부각합니다.
2 관련 연구 (Related Works)
2.1 LLM 기반 멀티에이전트
에이전트가 인간 행동을 모사하는 환경을 도입하고, 신뢰할 수 있는 인간 행동 시뮬레이션을 가능하게 하는 아키텍처 및 상호작용 패턴을 제안합니다.
각 에이전트의 상태를 수치적으로 표현하고, 에이전트들이 협상을 통해 공동의 합의에 도달하는 합의 추구 과제를 제안합니다. 그러나 멀티에이전트 시스템이 잘 연구된 과제를 해결하는 데 자주 활용되는 반면, 사회과학적 관점
—특히 집단 동조에서 나타나는 에이전트의 편향을 다루는 연구—
은 여전히 충분히 탐구되지 않았습니다. 이러한 공백을 해소하기 위해, 본 연구는 각 에이전트의 특성에 따라 동조 효과가 어떻게 나타나고 달라지는지를 조사합니다.
2.2 LLM의 편향 (Bias in LLM)
AI 안전성에 대한 사회적 관심이 증가함에 따라, LLM의 편향에 관한 연구 또한 확장되고 있습니다. 여기에는 벤치마크 데이터셋을 개발하려는 노력과 알고리즘적 편향을 분석하는 연구가 포함됩니다. LLM은 기존 사회적 편향을 반영할 수 있는 대규모 데이터셋으로 학습되기 때문에, 왜곡된 표현을 내재화하고 전파할 상당한 위험이 존재합니다. 그 결과, 소수자나 취약 집단의 관점뿐만 아니라 특정 문화, 인종, 성별이 간과되거나 왜곡될 수 있습니다.
Tjuatja et al.(2024)은 LLM에서의 사회적 편향을 추가로 분석하며, 서로 다른 사회적 관점이 이러한 편향의 발생에 어떻게 기여하는지를 탐구합니다.
기존 연구들은 주로 LLM이 생성한 콘텐츠에서 명시적 편향을 측정하고 완화하는 데 초점을 맞추어 왔으나, 에이전트 간 상호작용을 통해 편향이 어떻게 생성되고 진화하는지는 아직 충분히 연구되지 않았습니다.
최근 연구(Taubenfeld et al., 2024)는 멀티에이전트 상호작용에서 LLM 에이전트가 사회적 편향을 보이며, 이러한 편향이 미세조정을 통해 완화될 수 있음을 시사합니다. 그러나 해당 연구는 주로 멀티에이전트 환경에서 고유 편향이 어떻게 드러나는지를 분석하는 데 초점을 두고 있습니다. 반면 본 연구는 다섯 가지 주요 사회적 주제를 선택하여 토론을 구성하고, 이러한 상호작용 시나리오에서 집단 동조 역학이 어떻게 전개되며 에이전트의 편향이 강화되는지 혹은 완화되는지를 분석하는 데 초점을 둡니다.2.3 집단 역학과 동조 (Group Dynamics and Conformity)
집단 동조는 사회심리학에서 잘 문서화된 현상으로, 다양한 맥락에서 인간의 의사결정에 영향을 미쳐 왔습니다. 기초 연구들은 개인이 다수 의견에 의해 쉽게 영향을 받는다는 점을 보여주었으며, 이는 방관자 개입과 집단 동조에 관한 고전적 실험을 통해 입증되었습니다. 침묵의 나선과 집단 극화와 같은 현상의 등장은 사회적 압력이 반대 의견을 억압하고, 의견을 극단으로 몰아갈 수 있음을 보여줍니다. 또한 사회적 영향, 순응, 비교에 대한 연구는 이러한 역학을 이해하기 위한 탄탄한 이론적 틀을 제공합니다.
이러한 통찰은 멀티에이전트 시스템에서 특히 중요합니다. LLM 간 상호작용은 동조에 의해 주도되는 편향 증폭을 초래할 수 있으며, 지배적인 관점을 강화하는 동시에 소수의 시각을 주변화할 수 있기 때문입니다. 본 연구는 이러한 원리를 적용하여 LLM 기반 토론에서 동조 효과가 어떻게 나타나는지를 분석하고, 그로 인한 편향 전파의 함의를 고찰합니다.
3 실험 설정 (Experimental Setup)
3.1 연구 목적 및 가설 (Objective and Hypotheses)
본 연구의 목적은 LLM 에이전트 간 토론에서 나타나는 동조 현상을 분석하는 것입니다.
구체적으로, 찬성(proponent) 및 반대(opponent) 집단의 에이전트 수와 지능 수준이 중립(neutral) 에이전트의 동조에 어떠한 영향을 미치는지를 검토합니다. 본 연구에서 설정한 가설은 다음과 같습니다.
- H1: 한 집단에 더 많은 에이전트가 존재할 경우, LLM 에이전트는 다수 의견에 동조할 것이다.
- H2: LLM 에이전트는 상대적으로 더 높은 지능을 가진 집단에 동조하는 경향을 보일 것이다.
- H3: 두 집단 간 에이전트 수의 차이가 클수록, 다수 집단에 대한 동조는 더욱 강해질 것이다.
본 연구는 토론 시뮬레이션에 초점을 두므로, 지능을 복잡한 언어 이해 능력에 대한 모델의 역량으로 조작화합니다. 대규모 LLM이 복잡한 언어 과제에서 더 우수한 성능을 보인다는 MMLU와 같은 벤치마크 결과를 바탕으로, 본 실험에서는 모델의 파라미터 크기를 지능의 실용적인 대리 변수로 사용합니다.
3.2 실험 설계 (Experimental Design)
연구 목적을 평가하고 제안한 가설을 검증하기 위해, 본 연구에서는 상호 보완적인 두 가지 실험을 설계합니다.
LLM은 중립적인 역할을 부여받았음에도 불구하고 주제에 따라 편향을 보일 수 있음이 선행 연구에서 보고되었으므로, 토론 시뮬레이션에 앞서 중립 에이전트의 초기 성향을 평가하기 위한 사전(proxy) 테스트를 먼저 수행하였습니다.
이 사전 테스트에서는 균형 잡힌 찬·반 논거를 제시한 후, 에이전트에게 더 설득력 있는 쪽을 선택하거나 “No response”로 응답하도록 하였습니다.
부록 C의 결과는 주제별 선호가 존재함을 확인해 주었습니다.
이러한 문제를 해결하기 위해, 본 연구는 실험을 짝지은 비교(paired comparison) 설계(예: 찬성 다수 vs. 반대 다수)로 구성하여, 기준선 편향이 조건 전반에 걸쳐 동일하게 분포되도록 하였습니다.
이러한 설계 선택은 주요 관심 변수인 집단 구성과 지능의 효과를 보다 효과적으로 분리해 분석할 수 있도록 합니다.
실험 A (동조에 대한 다수 효과와 지능 효과)
집단 규모와 지능 수준의 차이가 중립 에이전트의 동조에 미치는 영향을 분석하며, H1과 H2를 검증합니다.
H1과 H2를 검증하기 위해, 에이전트 수와 지능 수준을 변화시키면서 동조를 측정합니다.
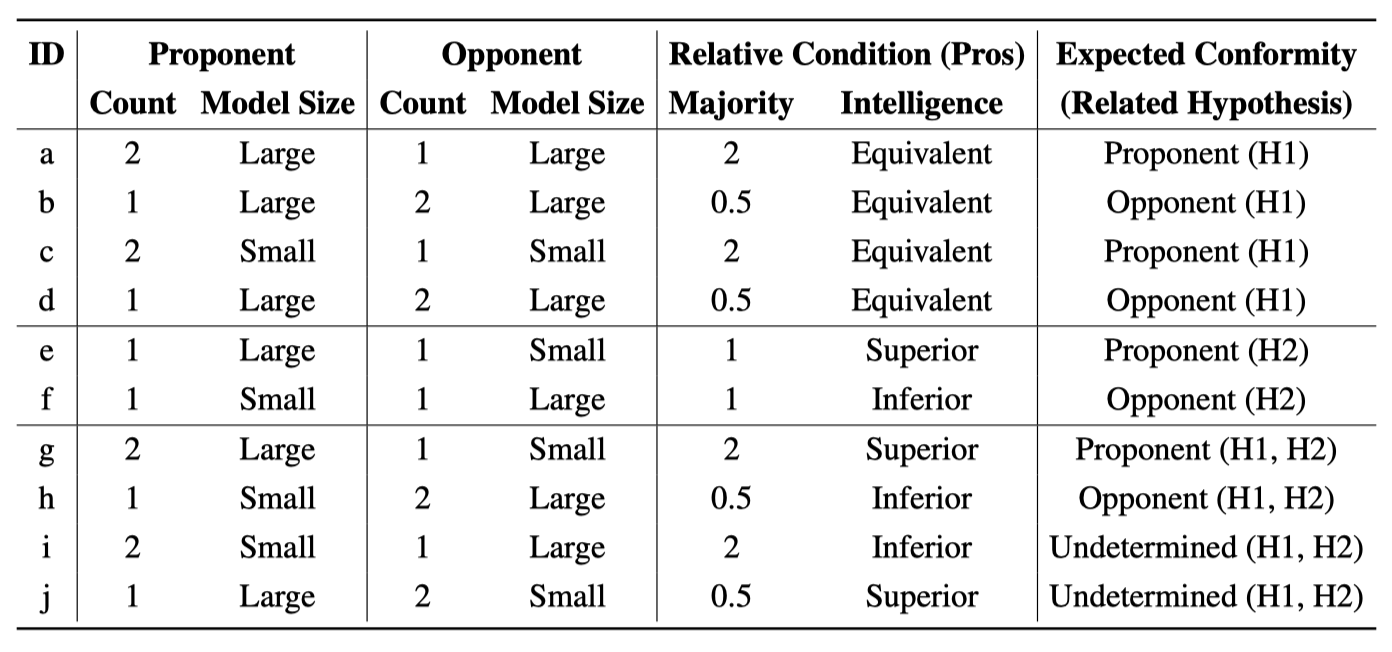
표 1에 제시된 바와 같이 (a)부터 (j)까지 총 10개의 토론 시나리오를 실행합니다. H1(다수 효과)을 검증하기 위해, 양 집단에 동일한 LLM 모델을 사용하여 지능 수준을 통제하고, 찬성 및 반대 집단의 에이전트 수만을 변화시킵니다(예: 1명 대 2명). 이 설정에서 동조율(conformity rate)과 완전 동조 비율(full conformity ratio)을 비교하며, 이는 시나리오 (a, c)와 (b, d)의 비교에 해당합니다.
H2(에이전트 지능 효과)를 검증하기 위해서는 에이전트 수를 통제한 상태에서, 서로 다른 파라미터 크기(대형 vs. 소형)의 모델을 할당하여 지능 우위를 조작하며, 이는 시나리오 (e)와 (f)의 비교에 해당합니다. 또한 다수 영향과 지능 수준 간 상호작용을 분석하기 위해, 시나리오 (g, h, i, j)에 대한 추가 실험을 수행합니다.
실험 B (다수–소수 비율이 동조에 미치는 영향)
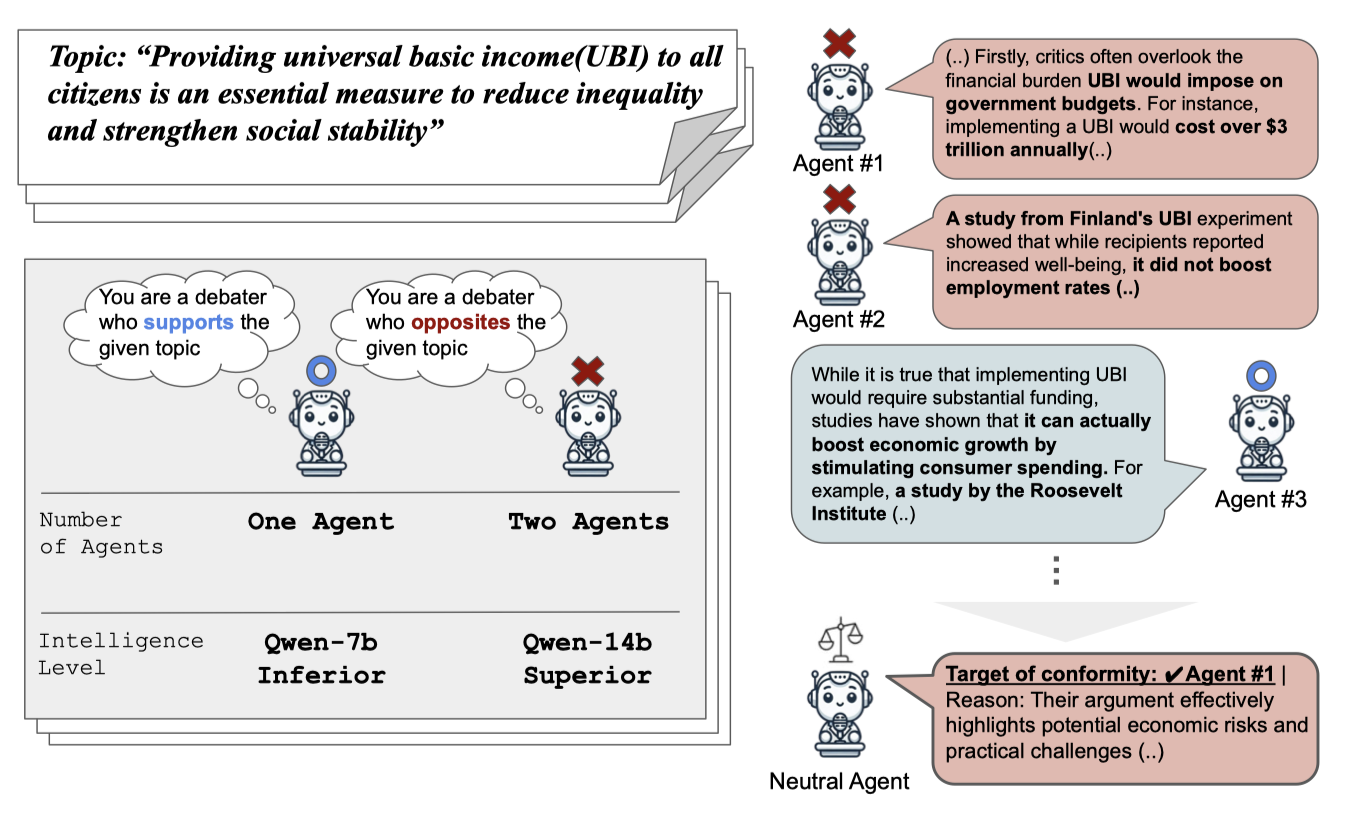
지능 수준을 고정한 상태에서 다수–소수 비율의 영향을 분리하여, 집단 규모 격차가 다수에 대한 동조를 증폭시키는지를 평가하며 H3를 검증합니다. 그림 1은 본 연구의 시뮬레이션 프레임워크를 개괄적으로 제시합니다.
H3를 검증하기 위해, 실험 A를 확장하여 지능 수준을 고정한 상태에서 에이전트 수를 증가시키는 추가 실험을 수행합니다. OpenAI의 GPT-4o-mini와 GPT-3.5-turbo를 사용하여 각 시나리오에서 에이전트 수를 확장하였으며, 구체적으로 찬성–반대 에이전트 비율을 1:2에서 1:4, 1:8로 변화시켰습니다.
3.3 LLM 에이전트 토론 시스템 설정 (LLM Agent Debate System Setup)
토론 프로토콜 (Discussion Protocol)
본 연구에서 LLM 에이전트는 구조화된 프로토콜에 따라 토론에 참여합니다. 각 토론 주제에 대해 찬성 및 반대 에이전트는 턴마다 각각 세 번의 발언 기회를 가집니다. 발언 순서는 각 토론이 시작될 때 무작위로 결정되며, 전체 토론은 총 세 개의 턴으로 구성됩니다. 각 턴이 종료될 때마다, 엄격히 중립적 입장을 유지하는 중립 에이전트가 양측의 논거를 평가하고 가장 설득력 있는 에이전트를 선택합니다. 이러한 턴별 평가와 후속 점수화 메커니즘을 통해 각 토론에서의 동조를 정량적으로 평가할 수 있습니다. 중립 에이전트의 선택 결과를 바탕으로, 본 연구에서는 두 가지 핵심 지표인 동조율(Conformity Rate, CR)과 완전 동조 비율(Full Conformity Ratio, FCR)을 측정합니다.CR은 중립 에이전트가 찬성 측에 정렬한 턴의 비율을 의미합니다. 반대 측에 대한 동조는 (1 - CR_{\text{proponent}})와 동일하므로, 본 연구에서는 찬성 측 비율만을 보고합니다. CR은 다음과 같이 계산됩니다.
[
CR = \frac{\text{ProponentSupportedTurns}}{\text{TotalTurns}}
]여기서 TotalTurns는 전체 토론 턴 수를, ProponentSupportedTurns는 중립 에이전트가 찬성 측을 지지한 턴 수를 의미합니다.
FCR은 중립 에이전트가 모든 턴에서 일관되게 찬성 측을 지지한 토론(예: 3:0 결과)의 비율을 나타내며, 다음과 같이 정의됩니다.
[
FCR = \frac{\text{FullyProponentSupportedDiscussions}}{\text{TotalDiscussions}}
]여기서 FullyProponentSupportedDiscussions는 찬성 측을 전 턴에서 지지한 토론의 수를, TotalDiscussions는 전체 토론 수를 의미합니다.
에이전트 구성 및 프롬프트 (Agent Configuration and Prompts)
본 연구에서는 GPT, Claude, Qwen의 세 가지 LLM 계열에서 찬성 및 반대 에이전트를 선택중립 에이전트는 가장 진보된 LLM 중 하나인 GPT-4o를 사용하여 일관되게 구성하였습니다.
모든 에이전트는 사전 정의된 프롬프트와 응답 변동성을 통제하기 위한 고정 온도 값 0.7로 초기화됩니다. 에이전트는 할당된 입장을 따르며, 상대를 설득하려는 시도를 적극적으로 수행합니다. 응답 길이는 찬성 및 반대 에이전트의 경우 최대 256 토큰, 중립 조정자의 경우 최대 1024 토큰으로 제한하였습니다.
토론 주제 (Discussion Topics)
본 연구에서는 사회과학 연구자들의 자문을 바탕으로 다섯 가지 주요 사회적 이슈를 선정하였습니다:기본소득, 성별 임금 격차, 이민 정책, 교육 평등, 사형 제도. 명확한 옳고 그름이 존재하는 공정성(fairness) 관련 이슈와 달리, 이들 주제는 에이전트 간 설득과 동조 역학이 발생할 수 있는 합리적 논의 프레임워크를 형성하도록 선택되었습니다. 각 주제와 이에 대응하는 찬성 진술은 다음과 같습니다.
- 기본소득: “모든 시민에게 보편적 기본소득을 제공하는 것은 불평등을 완화하고 사회적 안정을 강화하기 위한 필수적인 조치이다.”
- 이민 정책: “경제 성장을 촉진하기 위해 이민 정책은 완화되어야 하며, 이민자에게 더 많은 기회가 제공되어야 한다.”
- 사형 제도: “범죄 억제와 사회적 정의 실현을 위해 사형 제도는 유지되고 집행되어야 한다.”
- 교육 평등: “교육적 형평성을 달성하기 위해 엘리트 교육은 축소되고, 모든 학생이 동등한 교육 기회를 가질 수 있도록 공교육 시스템이 강화되어야 한다.”
- 성별 임금 격차: “성별 임금 격차를 해소하기 위해 정부는 포괄적인 동일임금 입법을 강제해야 한다.”
3.4 통계적 방법 (Statistical Methods)
본 연구에서는 토론 시뮬레이션을 통계적으로 검증하기 위해 카이제곱 검정과 이원 분산분석를 사용하였으며, 모든 검정에 대해 유의수준 (\alpha = 0.01)을 적용하였습니다. 이러한 방법론적 접근은 에이전트 수와 지능이 LLM 에이전트 상호작용에서의 동조에 미치는 영향을 엄밀하게 분석할 수 있도록 합니다.
카이제곱 검정 (Chi-square Test)
카이제곱 검정은 범주형 변수의 독립성을 평가하기 위해 사용되며, 본 연구에서는 집단 간(예: 찬성 다수 vs. 반대 다수) 동조율의 유의미한 차이를 검정하는 데 적용됩니다. 가설은 다음과 같이 정의됩니다.- H0: 집단 간 동조율에는 유의미한 차이가 없다.
- HA: 집단 간 동조율에는 유의미한 차이가 있다.
검정 통계량은 다음과 같이 계산됩니다.
[
\chi^2 = \sum \frac{(O_{ij} - E_{ij})^2}{E_{ij}}
]여기서 각 항은 표준적인 카이제곱 공식(Pearson, 1900)을 따르며, 추가적인 세부 사항은 부록 B에 제시되어 있습니다.
이원 분산분석 및 강건 대안 (Two-Way ANOVA and Robust Alternatives)
에이전트 수(A)와 에이전트 지능(B)이 동조율(Y)에 미치는 주효과와 상호작용 효과를 평가하기 위해, 다음과 같은 이원 분산분석 모형을 고려하였습니다.[
Y_{ijk} = \mu + \alpha_i + \beta_j + (\alpha\beta){ij} + \epsilon{ijk}
]여기서 각 항은 표준 ANOVA 공식(Scheffe, 1999)을 따르며, F-통계량 계산을 포함한 추가적인 세부 내용은 부록 B에 제시되어 있습니다.
ANOVA 결과의 타당성을 확보하기 위해, Shapiro–Wilk 검정(Shaphiro and Wilk, 1965)과 Levene 검정(Levene, 1960)을 사용하여 각각 정규성과 분산 동질성을 평가합니다. 이러한 가정이 위배되는 경우, Welch의 ANOVA(Welch, 1951)와 Games–Howell 사후 검정(Games and Howell, 1976)과 같은 강건한 대안을 사용하여 쌍대 비교를 수행합니다. 또한 관측된 효과의 크기를 정량화하기 위해 효과 크기 지표(예: ( \eta_p^2 ))를 함께 보고합니다.
4 논의 (Discussion)
4.1 다수성과 지능이 동조에 미치는 영향
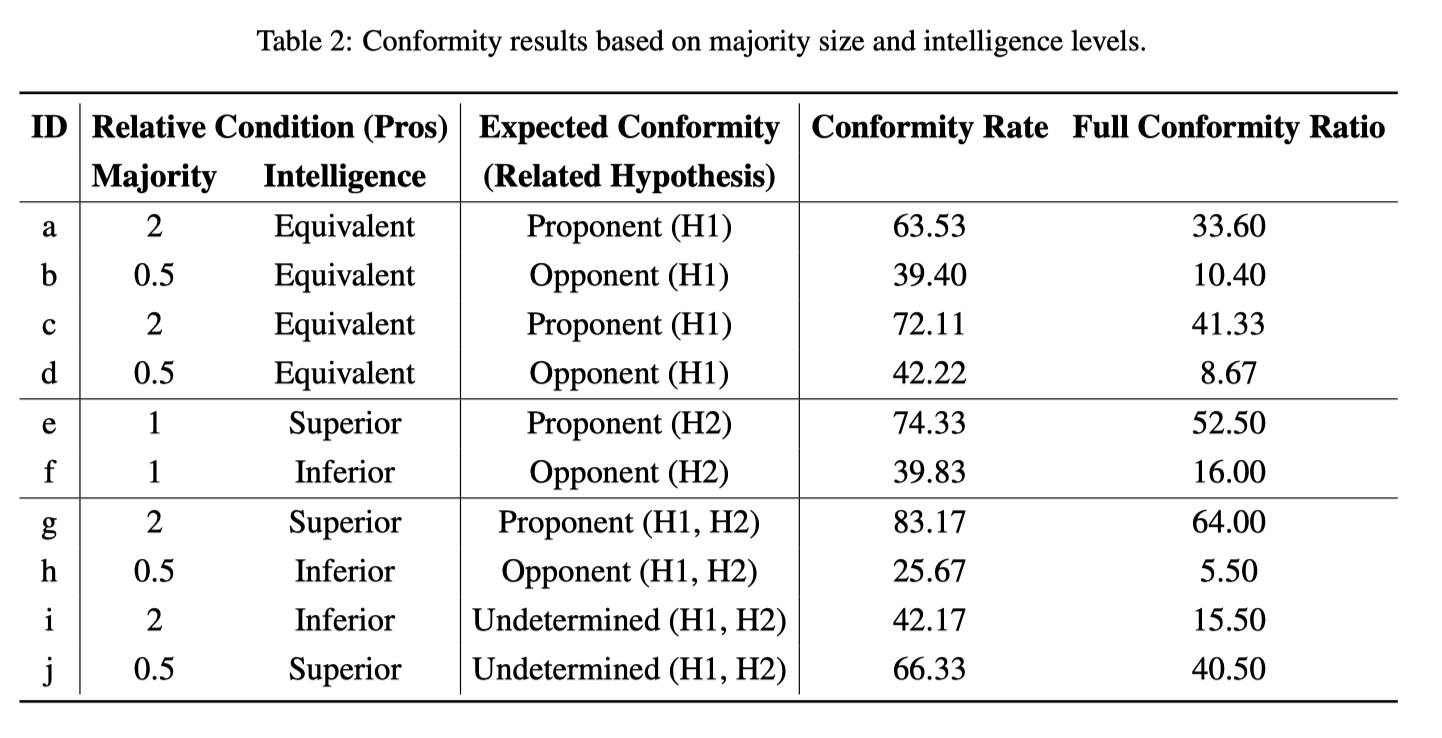
표 2에 제시된 집계된 시뮬레이션 결과에 대해 카이제곱 검정을 수행하여 가설을 검증하였습니다.
시나리오 (a–d)는 중립 에이전트가 다수 집단에 유의미하게 더 높은 확률로 동조함을 확인해 주며(χ² = 164.839, p < 0.001, df = 1), 시나리오 (e–f)는 보다 논리적이고 설득력 있는 주장을 제시하는 고지능 에이전트가 중립 에이전트가 해당 입장에 동조할 가능성을 유의미하게 증가시킴을 보여줍니다(χ² = 142.285, p < 0.001, df = 1).
이러한 효과의 크기를 보다 심층적으로 탐구하기 위해, 다수성, 지능, 그리고 동조 간의 관계를 시각화하였습니다.
그림 2에 나타난 바와 같이, 세 가지 핵심적인 패턴이 관찰됩니다.
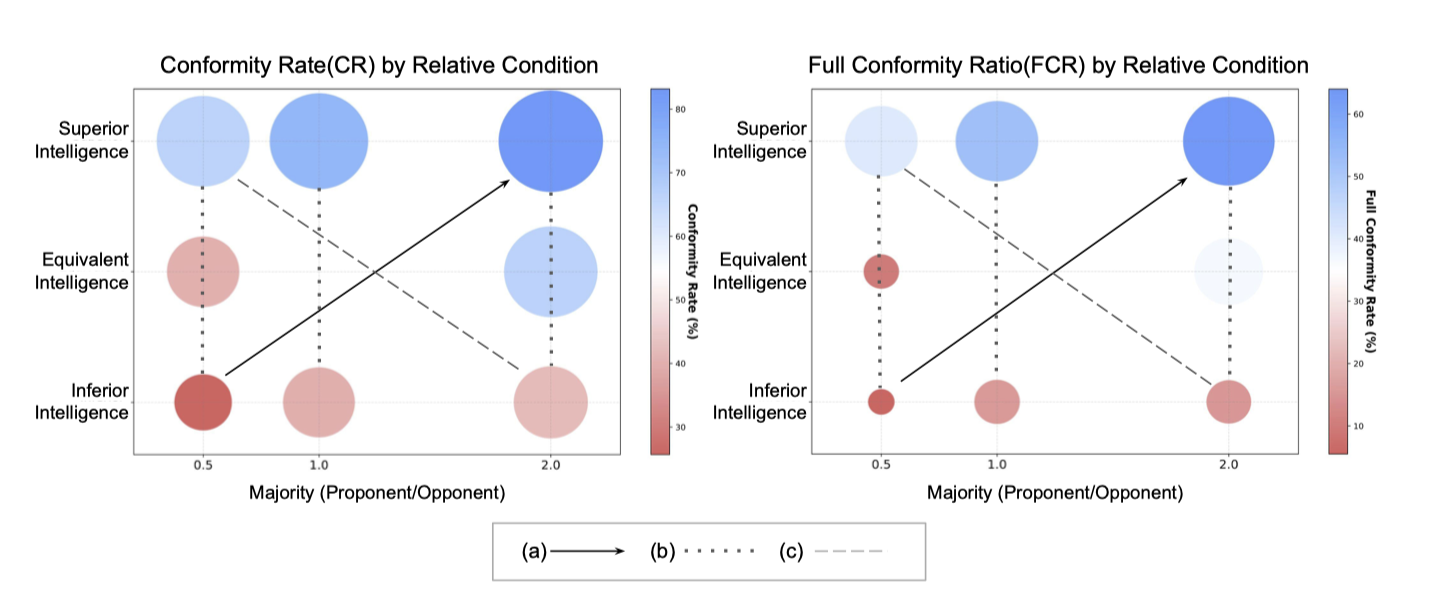
첫째, 상대적인 다수성과 지능 조건이 모두 증가할수록 동조가 명확하게 증가합니다. 둘째, 지능이 우수한 집단은 지능이 낮은 집단에 비해 일관되게 더 높은 동조를 유도합니다. 셋째, 중립 에이전트는 규모가 크지만 지능이 낮은 집단보다, 규모는 작더라도 지능이 높은 집단에 더 쉽게 동조하는 경향을 보입니다. 또한 전면적 동조(full conformity)의 극단적인 사례도 관찰되었는데, 이는 다수의 영향력이 개인의 의사결정을 형성하는 강력한 힘을 지닌다는 인간 집단 행동에 관한 선행 연구(Asch, 1955; Milgram, 1963)와도 일치합니다.
이러한 시각적 관찰을 통계적으로 검증하기 위해, 정규성과 분산 동질성 가정 위반을 고려하여 Welch의 ANOVA를 수행하였습니다. 분석 결과, 다수 집단 규모는 중간 수준의 효과를 보인 반면(η²ₚ ≈ 0.068), 지능은 훨씬 더 큰 영향을 미쳤으며(η²ₚ ≈ 0.1665), 이는 큰 효과 크기로 분류됩니다(Cohen, 2013). 사후 검정력 분석(post hoc power analysis) 결과, 지능 효과를 탐지하기 위한 통계적 검정력이 0.99를 상회함을 확인하였으며, 이는 본 결과의 강건성을 뒷받침합니다. 참고로, 서로 다른 LLM 제공자에 따른 이원 분산분석 및 통계적 유의성 검정의 상세 결과는 부록 C에 제시되어 있습니다. 이러한 결과는 LLM 기반 토론에서 수적 우위보다 논리적이고 설득력 있는 주장이 더 큰 영향을 미치며, 고급 모델이 멀티에이전트 시스템 내 담론을 불균형적으로 형성할 수 있음을 시사합니다.
다수–소수 비율에 대한 확장 분석
실험 B를 통해, 다수–소수 비율이 2:1을 초과하여 증가할 경우(예: 4:1, 8:1) 동조가 더욱 강화되는지를 추가로 분석하였습니다. 그 결과, 부록의 그림 5에 나타난 바와 같이 비율이 커질수록 동조가 점진적으로 증가하는 경향이 확인되었습니다. 이러한 효과는 GPT-3.5-turbo에서 특히 두드러지게 나타났으며, 다수 규모가 커질수록 동조율이 비례적으로 증가하였습니다. 반면, 상대적으로 지능이 높은 GPT-4o-mini에서는 수적 우위와 동조 간의 관계가 더 약하게 나타났습니다.4.2 토론 주제별 동조 패턴
(Conformity Patterns Across Debate Topics)
서로 다른 주제 전반에서 본 연구 결과의 강건성을 평가하기 위해, 각 토론 주제별 동조율(CR)의 분포를 분석하였습니다. 주목할 점은, 다섯 가지 모든 토론 주제에서 동조 경향이 일관되게 유지되었다는 것으로, 이는 관찰된 효과가 특정 주제에 국한되지 않는 일반적인 에이전트 행동 패턴임을 시사합니다.
그림 3은 다수 효과를 중심으로 한 시나리오 (a–d)의 CR 분포를 보여줍니다. 이 그림에서 파란색 막대는 찬성 다수 토론을, 빨간색 막대는 반대 다수 시나리오를 나타냅니다. 예상한 바와 같이, 파란색 막대는 좌측으로, 빨간색 막대는 우측으로 치우치며, 이는 중립 에이전트가 지배적인 다수에 정렬하는 교차 패턴을 형성합니다. 에이전트 지능의 영향을 분석한 시나리오 (e–f)에서도 유사한 패턴이 관찰되었으며, 이에 대한 세부 결과는 부록의 그림 6에 제시되어 있습니다.
일부 변동성은 존재하지만, 사형 제도에 관한 토론에서는 특히 뚜렷한 좌측 이동이 관찰되었는데, 이는 LLM이 반대 측 관점에 대해 강한 암묵적 편향을 지니고 있음을 시사합니다. 이러한 결과는 민감한 주제에 대해 LLM 생성 콘텐츠에서 체계적인 편향이 나타난다는 선행 연구(Taubenfeld et al., 2024)와도 일치합니다. 그럼에도 불구하고, 모든 시나리오에서 다수 집단에 따라 동조율이 일관되게 왜곡되는 양상은 본 연구의 가설을 다시 한번 뒷받침합니다. 즉, 다수성과 지능은 토론 주제와 무관하게 중립 에이전트의 동조에 예측 가능한 영향을 미칩니다. 또한 LLM이 프롬프트 구성에 민감하다는 점을 고려하여, 반대 입장을 선호하도록 설계된 주제 문구를 사용한 추가 실험을 수행하였습니다. 부록 C에 제시된 바와 같이, 이 경우에도 동조 패턴은 일관되게 유지되었으며, 이는 본 연구에서 관찰된 효과가 프롬프트 문구의 산물이 아니라 집단 영향의 실제 역학을 반영함을 시사합니다.
4.3 정성적 분석
(Qualitative Analysis)
마지막으로, 집단 극화(group polarization)와 침묵의 나선(spiral of silence)과 같은 사회과학 이론을 참조하여, 에이전트 토론 과정에서 관찰된 동조 현상을 정성적으로 보고합니다.
집단 극화 (Group Polarization)
집단 극화는 집단 토론이 구성원들의 초기 견해를 증폭시켜, 보다 극단적인 입장으로 이동하게 만드는 경향을 의미합니다(Isenberg, 1986). 찬성 에이전트가 8명, 반대 에이전트가 1명인 것과 같이 에이전트 수의 불균형이 큰 시나리오에서는, 토론이 진행될수록 다수 집단의 의견이 점점 더 극단화되는 양상이 관찰되었습니다. 예를 들어, 그림 4에 제시된 바와 같이 “엘리트 교육은 축소되어야 한다”는 주제에 대한 토론에서, 다수 집단에 속한 일부 에이전트의 주장은 시간이 지남에 따라 점진적으로 더욱 극단적인 방향으로 변화하였습니다.침묵의 나선 (Spiral of Silence)
각 토론자는 상대의 견해에 전적으로 동의하고 토론을 종료하고자 할 경우 ‘완전 동의(complete agreement)’를 선언할 수 있도록 하는 프롬프트를 부여받습니다. 이 메커니즘은 소수 집단이 침묵하거나 반대 의견 표명을 자제하는 침묵의 나선 현상(Noelle-Neumann, 1974)을 반영하도록 설계되었습니다. 다양한 토론 전반에서, 수적 또는 지능적 측면에서 소수에 해당하는 집단의 에이전트들 사이에서 ‘완전 동의’ 사례가 관찰되었습니다. 이러한 사례에 대한 구체적인 예시는 부록 E에 상세히 기록되어 있습니다.
아래는 요약·의역 없이 원문의 의미와 구조를 그대로 보존한 한국어 번역입니다.
5 결론 (Conclusion)
본 연구의 결과는 LLM 에이전트가 인간의 의견 역학과 유사한 동조 패턴을 보인다는 점을 시사합니다. 본 연구는 다수성과 지능이 동조에 미치는 영향을 분석함으로써 선행 연구를 확장합니다. 특히, 고지능 모델은 소수에 속하더라도 집단 역학에 더 강한 영향을 미친다는 점을 확인하였습니다. 이러한 행동은 지식이 풍부한 개인이 수적으로 열세에 있더라도 의견을 설득하고 변화시킬 수 있는 인간 사회 행동과 유사합니다. 이러한 결과는 LLM 주도 담론에서 편향이 전파될 잠재적 위험성을 강조하며, 다양하고 투명한 공적 논의를 촉진하기 위한 정책적 필요성을 시사합니다.
한계점 (Limitations)
본 연구는 제한된 수의 토론 주제만을 다루고 있습니다. 또한 사회적 이슈(예: 정치, 문화)에 대한 분류 역시 충분히 다루어지지 않았습니다. 토론을 영어로만 수행한 점은 문화적·언어적 편향을 초래했을 가능성이 있습니다. 향후 연구에서는 토론 주제와 사용 언어의 범위를 확장하여 결과의 일반화 가능성을 높일 수 있을 것입니다. 본 연구는 LLM 간 상호작용에 초점을 맞추었으며, 담론 형성에서 인간 개입의 역할은 고려하지 않았습니다. LLM이 생성한 콘텐츠가 공적 여론이나 의사결정 과정에 영향을 미칠 가능성은 존재하지만, 그 영향의 범위와 정도는 아직 명확하지 않습니다. 향후 연구에서는 인간–AI 상호작용을 보다 심층적으로 탐구하여, 인간의 개입이 동조 패턴과 의견 역학에 어떠한 영향을 미치는지를 규명할 필요가 있습니다.'논문' 카테고리의 다른 글